
[논문리뷰] 3DGS-CD: 3D Gaussian Splatting-based Change Detection for Physical Object Rearrangement (RA-L 2025)
시점이 정렬되지 않은 변화 전후 이미지들로부터 “무엇이 옮겨졌는지”를 3D에서 찾는 문제를 3DGS로 푸는 첫 방법, 3DGS-CD(IEEE RA-L 2025)를 리뷰한다. depth 센서도, 물체 클래스도, 사용자 prompt도 없이 변화 후 이미지 1장만으로 물체의 3D mask와 6D pose 변화를 추정하며, 코드와 데이터셋이 공개되어 있다.
논문 정보
| 항목 | 내용 |
|---|---|
| 제목 | 3DGS-CD: 3D Gaussian Splatting-based Change Detection for Physical Object Rearrangement |
| 저자 | Ziqi Lu, Jianbo Ye, John Leonard |
| 소속 / 연도 | MIT CSAIL, 2025 (arXiv:2411.03706, IEEE RA-L 2025) |
| 분야 | 3D Change Detection |
| 코드 | GitHub |
I. Introduction
3D change detection은 서로 다른 시점에 찍힌 두 관측 집합, 또는 이미 modeling된 scene의 새 관측으로부터 환경에서 변한 물체나 영역을 찾는 문제다. 로보틱스에서 특히 중요한데, 짧은 시간의 연속 관측 동역학뿐 아니라 변화 과정 자체는 관측되지 않는 장기 scene 변화까지 다룰 수 있기 때문이다. 환경 변화는 대개 감시되지 않은 채 일어나므로, 이런 장기 변화 포착이 로봇 운용에 중요하다.
TSDF, 3D point cloud, neural descriptor field 같은 표현으로 depth 입력 기반 3D change detection은 성공을 거뒀지만, multi-view RGB 이미지만으로 변화를 찾는 것은 여전히 어렵다. 전통적 방법은 voxel화, multi-view stereo, 이미지 warping 같은 수작업 기법으로 미정렬 이미지의 변화를 찾아 3D로 올렸는데, 두 이미지 집합의 시점 차이가 클수록 occlusion과 조명 변화에 민감하다.
NeRF와 3DGS 같은 radiance field 모델의 등장은 새로운 기회를 연다. scene의 기하와 외형을 고충실도로 표현하고 임의 시점에서 photo-realistic 이미지와 dense depth를 렌더링할 수 있으므로, 같은 시점에서 변화 전후 이미지를 직접 비교할 수 있게 된다. NeRF 기반 해법이 제한적으로 탐구됐지만 ray casting 렌더링의 계산 비용에 발목 잡혔고, 3DGS는 실시간 렌더링으로 대등하거나 더 나은 품질을 내는 효율적 대안이다.
이 논문은 3DGS를 scene 표현으로 활용해 multi-view 이미지로부터 물체 제거·삽입·이동을 포함한 3D scene 변화를 찾는다. EfficientSAM의 zero-shot 분할 능력으로 같은 시점의 변화 전후 이미지를 비교하고, 2D 물체 변화를 view들에 걸쳐 연결·융합해 정확한 물체 3D change mask와 6D pose 변화를 얻는다. 핵심 장점은 다음과 같다.
- 변화 후 이미지가 sparse해도 된다. 단 1장으로도 3D 변화를 감지한다
- depth 센서나 monocular depth estimator가 필요 없다
- 미리 정의된 물체 클래스, model, detector에 의존하지 않는다. 옮겨지거나 제거·삽입되었다는 사실만으로 물체가 인식된다
- 클릭이나 언어 같은 사용자 prompt가 필요 없다
- radiance field 모델 선택에 무관해 원리상 NeRF나 2DGS로도 동작한다
공개·자체 수집 실세계 데이터셋 평가에서 state-of-the-art NeRF 기반 방법 대비 최대 14% 높은 정확도와 3자릿수 빠른 속도를 달성한다. 이 성능 향상은 물체 reconstruction의 prompt로서의 물체 제거(VI-A절), 로봇 작업 공간 리셋(VI-B절), 3DGS 모델 업데이트(VI-C절) 같은 응용을 가능하게 한다.
II. Related Work
II-A. Change detection from RGB images
이미지 쌍의 2D change detection은 오래 연구된 문제지만, 기존 방법 대부분은 이미지 사이 시점 차이가 minimal하다고 가정한다. 더 큰 시점 변화를 다루는 접근들도 주어진 view에 묶여 있어 3D의 물리적 변화를 온전히 포착하지 못한다. multi-view RGB의 3D change detection은 전통적으로 수작업 기법에 의존했다. NeRF 기반으로는 NeRF-Update가 NeRF와 SAM을 결합해 물체 이동을 감지하고, C-NeRF가 두 NeRF 사이의 방향 일관 radiance 차이로 scene 변화를 modeling했지만 NeRF의 느린 렌더링에 제약된다. 3DGS는 rasterization 기반 pipeline으로 실시간 렌더링을 제공하는데, SplatPose & Detect 같은 초기 연구가 anomaly detection에 3DGS를 썼을 뿐 change detection에 직접 적용한 시도는 거의 없었다. 이 논문은 3DGS의 효율적 novel view 렌더링을 빠른 3D scene change detection에 활용한다.
II-B. 3DGS as scene representation
3DGS는 최근 로보틱스의 핵심 scene 표현으로 떠올랐지만 변화 표현을 기본 지원하지 않는다. dynamic 3DGS 방법들이 비디오 시퀀스의 단기 동역학을 포착할 수 있으나, 대부분 변환 과정의 연속적인 시공간 관측에 의존한다. 이 논문은 3DGS로 표현된 scene의 변화를 감지함으로써 이 간극을 메운다.
III. Background
III-A. 3D Gaussian Splatting (3DGS)
3DGS는 3D Gaussian 집합 \(\mathcal{G}\) 로 scene의 기하와 외형을 명시적으로 encoding한다. 각 3D Gaussian은 평균(위치) \(\mu \in \mathbb{R}^3\), 공분산 행렬 \(\Sigma \in \mathbb{R}^{3 \times 3}\), 불투명도 \(\alpha \in \mathbb{R}\), 색 \(c \in \mathbb{R}^3\) 으로 정의된다. 카메라 파라미터를 아는 view에서 이미지를 렌더링하려면 3D Gaussian들을 카메라 2D 이미지 평면에 투영(splat)하고, 픽셀마다 그 픽셀에 투영되는 부분집합 \(\mathcal{G}_p\) 를 모아 depth로 정렬한다. 픽셀 \(p\) 의 색은 alpha-compositing으로 계산된다.
\[C(p) = \sum_{i \in \mathcal{G}_p} c_i\, \alpha_i(p) \prod_{j=1}^{i-1} \left( 1 - \alpha_j(p) \right)\]여기서 \(c_i\) 는 \(i\) 번째 Gaussian의 색, \(\alpha_i(p)\) 는 픽셀 \(p\) 에서 평가한 \(i\) 번째 splatted Gaussian의 불투명도다. 앞쪽 Gaussian들이 가리지 않고 남긴 투과율에 자신의 기여를 곱해 더하는 구조다. depth도 같은 방식으로 계산된다.
\[D(p) = \sum_{i \in \mathcal{G}_p} d_i\, \alpha_i(p) \prod_{j=1}^{i-1} \left( 1 - \alpha_j(p) \right)\]여기서 \(d_i\) 는 \(i\) 번째 splatted Gaussian의 depth다. 학습 시에는 렌더링 이미지와 ground truth 이미지의 오차(픽셀별 L1 + 구조 손실 D-SSIM)를 학습 view들에 대해 최소화하며 Gaussian 파라미터를 최적화한다.
III-B. EfficientSAM
SAM(Segment Anything Model)은 box나 점 같은 prompt로부터 분할하는 foundation model이고, EfficientSAM은 SAM을 활용한 masked image pretraining으로 만든 경량 SAM이다. encoder-decoder 구조 \(\mathcal{S} = \mathcal{S}_e \circ \mathcal{S}_d\) 로, encoder \(\mathcal{S}_e\) 는 입력 이미지 \(I \in \mathbb{R}^{H \times W \times 3}\) 의 embedding \(f \in \mathbb{R}^{h \times w \times d}\) 를 예측하고, decoder \(\mathcal{S}_d\) 는 embedding과 prompt \(\mathcal{P}\) 를 받아 분할 mask와 confidence를 출력한다.
\[\mathbf{M}, \mathbf{C} = \mathcal{S}(I, \mathcal{P}) = \mathcal{S}_d\left( \mathcal{S}_e(I), \mathcal{P} \right)\]이 논문은 EfficientSAM 이미지 embedding \(f = \mathcal{S}_e(I)\) 를 2D 물체 수준 change detection에 쓰고, box prompt \(\mathcal{B}\) 로 EfficientSAM을 query해 2D 물체 segment와 confidence를 얻는다.
IV. Methodology
목표는 두 RGB 이미지 집합, 즉 scene의 초기 정적 상태를 찍은 변화 전 이미지 \(\{I_m\}_{m=1}^{M}\) 과 변화 후 상태를 관측한(sparse할 수 있는) 이미지 \(\{I'_n\}_{n=1}^{N}\) 으로부터 물체 수준 변화를 감지하는 것이다. 출력은 재배치된 각 물체의 (1) 3D segmentation \(\mathcal{M}: \mathbb{R}^3 \to \{0, 1\}\) 과 (2) pose 변화 \(\mathcal{T} \in \mathrm{SE}(3)\) 다.
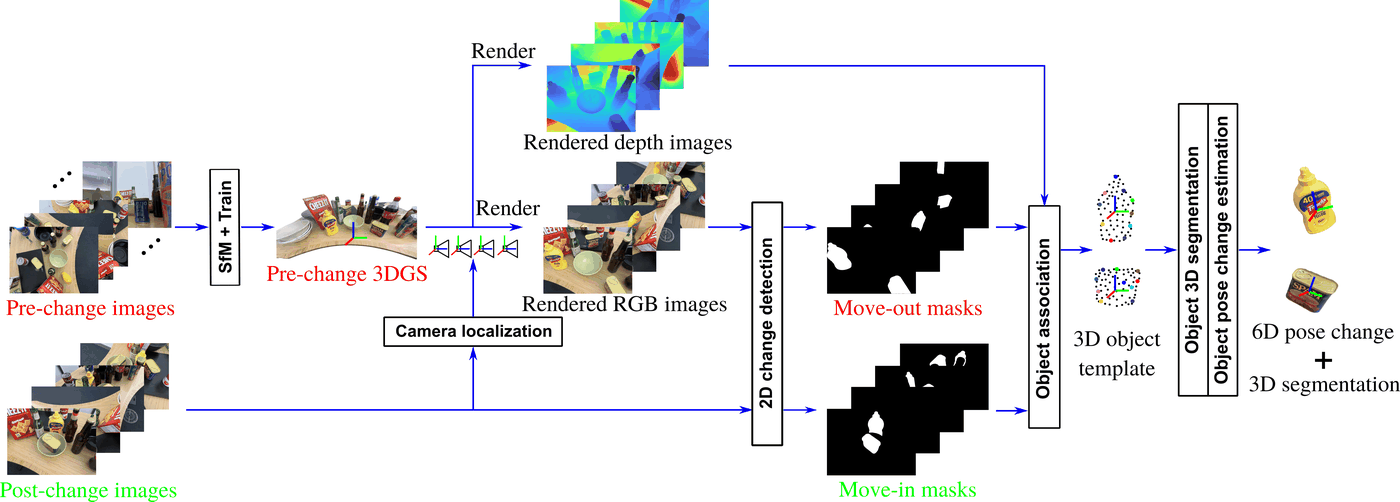 [Figure 1] 변화 전 3DGS 학습, 변화 후 카메라 localization, 2D change detection, 물체 연결, 3D 분할, pose 변화 추정·정제로 이어지는 모듈식 pipeline
pipeline은 모듈식으로 설계됐다(Figure 1). (1) 변화 전 3DGS 학습(IV-A), (2) 변화 후 카메라 localization(IV-B), (3) 변화 후 view에서의 2D change detection(IV-C), (4) 변화 후 view들 사이 물체 연결(IV-D), (5) 물체 3D 분할(IV-E), (6) 물체 pose 변화 추정(IV-F)과 정제(IV-G)로 구성되며, occlusion을 고려한 mask 투영(IV-H)과 구현 세부(IV-I)를 다룬다.
IV-A. Pre-change 3DGS training
변화 전 이미지 \(\{I_m\}_{m=1}^{M}\) 으로 3DGS 모델 \(\mathcal{G}\) 를 학습한다. 표준 3DGS 학습 절차대로 SfM으로 변화 전 카메라 파라미터를 추정하고 sparse point cloud를 만들어 3D Gaussian을 초기화한 뒤 최적화한다. SfM의 성공을 위해 변화 전 이미지가 scene을 충분히 덮어야 하지만, InstantSplat 같은 sparse-view 3DGS 학습 기법으로 이 요구는 완화될 수 있다.
IV-B. Post-change camera localization
변화 전 3DGS의 좌표계 안에서 변화 후 이미지들의 카메라 pose \(\{\mathcal{T}_{c'_n} \in \mathrm{SE}(3)\}_{n=1}^{N}\) 을 추정한다. 변화 후 이미지가 관측하는 scene 대부분이 변하지 않았다고 가정하고, 표준 visual localization 절차로 SfM point cloud에 대해 변화 후 카메라를 localization한다. 이 초기 pose 추정은 IV-G에서 더 정제된다.
IV-C. EfficientSAM embedding for 2D change detection
변화 후 카메라 view에서 변화 전 3DGS로 RGB 이미지를 렌더링하고, 촬영된 변화 후 이미지와 비교해 물체 수준 변화를 감지한다.
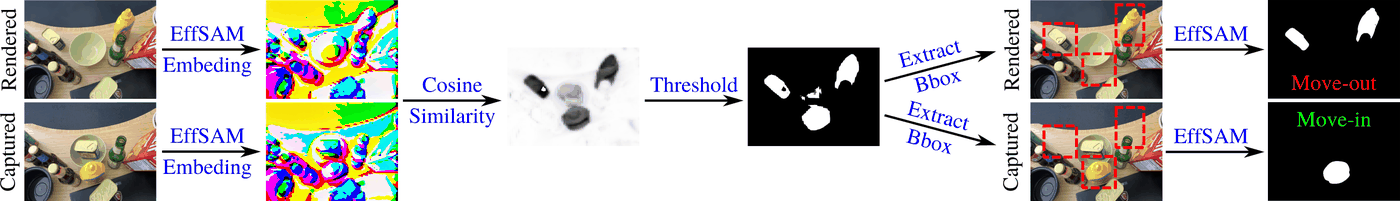 [Figure 2] 렌더링·촬영 이미지의 EfficientSAM embedding cosine 유사도 → threshold → bounding box 추출 → EfficientSAM query로 move-out/move-in mask를 얻는 과정
먼저 EfficientSAM 이미지 embedding으로 2D 변화를 거칠게 감지한다(Figure 2). 풍부한 semantic 정보를 담는 SAM embedding은 강건한 zero-shot change detection을 가능하게 한다고 알려져 있지만, SAM의 latent 공간 탐색은 비용이 크므로 경량 EfficientSAM encoder를 쓴다. 렌더링 이미지와 촬영된 변화 후 이미지의 embedding을 추출하고, 그 cosine 유사도 map을 threshold해 change mask를 얻는다.
\[\mathbf{M}^{\text{change}}_n = \left\langle \mathcal{S}_e\left[ \mathcal{R}(\mathcal{T}_{c'_n}; \mathcal{G}) \right],\; \mathcal{S}_e(I'_n) \right\rangle > \text{thresh.}\]여기서 \(\mathcal{R}(\mathcal{T}_{c'_n}; \mathcal{G})\) 는 view \(n\) 에서의 렌더링 이미지이고, embedding은 차분 전에 원본 이미지 해상도로 upscale하며, threshold는 Otsu 방법으로 동적으로 정한다. 이미지 어긋남과 3DGS floating artifact의 영향을 줄이기 위해 렌더링·촬영 이미지를 사전 정렬하고 blur를 적용한다.
change mask에서 충분한 2D 면적을 차지하는 윤곽을 추출하고, 그 bounding box로 렌더링 이미지와 촬영 이미지 각각에 EfficientSAM을 query한다.
\[\mathbf{M}_n, \mathbf{C}_n = \mathcal{S}\left[ \mathcal{R}(\mathcal{T}_{c'_n}),\; \mathcal{B}(\mathbf{M}^{\text{change}}_n) \right], \qquad \mathbf{M}'_n, \mathbf{C}'_n = \mathcal{S}\left[ I'_n,\; \mathcal{B}(\mathbf{M}^{\text{change}}_n) \right]\]여기서 \(\mathcal{B}(\cdot)\) 는 change mask에서 bounding box를 뽑는 연산이다. Figure 2처럼 렌더링 이미지의 고신뢰 2D segment는 재배치된 물체의 move-out mask(이전 위치), 촬영 이미지의 고신뢰 mask는 move-in mask(새 위치) 가 된다.
\[\{\mathrm{M}_{n,l}\}_{l=1}^{L} = \{\mathbf{M}_n \mid \mathbf{C}_n > 0.95\}, \qquad \{\mathrm{M}'_{n,l}\}_{l=1}^{L'} = \{\mathbf{M}'_n \mid \mathbf{C}'_n > 0.95\}\]여기서 \(l\) 은 view \(n\) 의 고신뢰 mask 인덱스다.
IV-D. Change-aware object association
변화 후 카메라 view들에 걸쳐 2D 물체 segment를 연결해 재배치된 물체를 3D에서 초기화한다. 초기화된 각 물체 template은 dense point cloud와 sparse 시각 feature point cloud로 구성되며, 공간적으로 가깝고 semantic이 유사한 segment들을 view에 걸쳐 증분적으로 모아 만든다.
먼저 변화 전 3DGS로 물체 move-out mask 안의 depth를 렌더링하고 3D로 역투영해 view별 부분 물체 point cloud를 얻는다.
\[X_{n,l} = \pi^{-1}\left[ \mathcal{R}^d(\mathcal{T}_{c'_n}) \cdot \mathrm{M}_{n,l} \right]\]여기서 \(\pi^{-1}(\cdot)\) 는 역투영 함수, \(\mathcal{R}^d(\cdot)\) 는 식 (2)의 3DGS depth 렌더링 함수다. move-out mask의 EfficientSAM embedding에 L1-median을 취해 view별·물체별 대표 embedding 벡터도 얻는다.
\[f_{n,l} = \mathrm{med}\left[ S_e(\mathcal{R}(\mathcal{T}_{c'_n})) \cdot \mathrm{M}_{n,l} \right]\]이 embedding 벡터는 연결 단계에서만 쓰이고 template에는 포함되지 않는다. 또한 move-out mask 안에서 sparse 시각 feature(SuperPoint)를 검출하고 3D로 역투영해 view별 sparse feature point cloud를 만든다.
\[F_{n,l} = \pi^{-1}\left\{ \phi\left[ \mathcal{R}(\mathcal{T}_{c'_n}) \cdot \mathrm{M}_{n,l} \right] \right\}\]여기서 \(\phi\) 는 feature 검출 함수다. 첫 view의 move-out mask에서 시작해, 현재 물체 point cloud와 다음 segment를 Hausdorff 거리 기반 Hungarian 알고리즘으로 매칭하며 남은 view들의 segment를 반복 연결한다. 매칭된 segment는 template에 추가하고 미매칭 segment는 새 template을 초기화한다. 매칭된 segment 쌍은 EfficientSAM embedding으로 semantic 유사성도 검증해, cosine 유사도가 40% 미만이면 새 template을 만든다. 연결이 끝나면 multi-view point cloud와 feature의 합집합으로 물체 template을 얻는다.
\[\left\{ O_k = \{X_k, F_k\} = \cup_n \{X_{n,k}, F_{n,k}\} \right\}_{k=1}^{K}\]여기서 \(k\) 는 \(k\) 번째 물체로 연결되는 mask들의 인덱스다.
move-out mask 연결은 물체를 변화 전 위치에서 초기화할 뿐이므로, 재배치를 식별하려면 template을 move-in mask와도 연결해야 한다. move-in mask에서도 같은 방식으로 multi-view embedding과 시각 feature를 추출한다.
\[f'_{n,l} = \mathrm{med}\left[ S_e(I'_n) \cdot \mathrm{M}'_{n,l} \right], \qquad F'_{n,l} = \phi\left( I'_n \cdot \mathrm{M}'_{n,l} \right)\]변화 후 이미지의 2D 물체 feature \(F'_{n,l}\) 을 3D template feature \(F_k\) 와 매칭해 2D-3D 대응을 만든다. 매칭 결과로 물체 수준 변화를 다음처럼 분류한다.
- 이동(Moved): 충분한 inlier 2D-3D 대응이 있는 template
- 제거(Removed): 충분한 inlier 대응이 없는 template
- 삽입(Inserted): 어떤 template과도 충분한 inlier 매칭이 없는 변화 후 segment
inlier 매칭은 RANSAC-PnP 알고리즘으로 판별한다(IV-F). 삽입된 segment는 위와 같은 연결 절차로 template을 초기화하되, 변화 후 view에는 depth가 없으므로 embedding 벡터 \(f'_{n,l}\) 의 cosine 유사도로 segment를 매칭한다.
IV-E. Object 3D segmentation
각 물체 template \(O_k\) 에 대해 multi-view mask 융합으로 3D segmentation mask \(\mathcal{M}_k\) 를 만든다. sparse할 수 있는 변화 후 view의 move-out mask만으로는 정확한 융합이 어려울 수 있어, 이동·제거된 물체의 point cloud를 변화 전 이미지들에 투영하고 2D bounding box로 EfficientSAM을 query해 move-out mask를 추가 확보한다(삽입 물체는 move-out mask가 없어 이 단계를 건너뛴다). occlusion에 강건하도록, 투영된 2D 물체 점의 80% 미만을 감싸는 mask는 걸러 가려지지 않았거나 조금만 가려진 mask만 융합한다.
융합은 각 template 주위에 3D 이진 voxel grid \(\mathcal{M}_k \in \{0,1\}^{N_x \times N_y \times N_z}\) 를 초기화하고, voxel이 물체 2D mask 대부분에 투영되면 물체 내부로 간주한다.
\[\mathcal{M}_k(x) = \frac{1}{N_k} \sum_{n_k=1}^{N_k} \mathbb{1}_{\left\{ \mathrm{M}_{n_k,k}\left[ \pi(x) \right] = 1 \right\}} > 0.95\]여기서 \(\pi\) 는 투영 함수, \(\mathbb{1}\) 은 지시 함수, \(n_k\) 는 \(k\) 번째 물체의 고신뢰·저occlusion mask를 가진 모든 변화 전후 이미지의 인덱스다. 실행 시에는 trilinear interpolation으로 임의 3D 위치를 빠르게 query하고, 점유 확률이 0.5를 넘으면 물체 내부로 본다.
IV-F. Object pose change estimation
이동한 물체에 대해 IV-D의 2D-3D 대응에 표준 RANSAC-PnP 알고리즘을 적용해 물체 pose 변화를 거칠게 추정한다. 초기 추정은 IV-G에서 최적화한다.
IV-G. Global pose refinement
초기 카메라·물체 pose 변화 추정을 analysis-by-synthesis 접근으로 정제한다. 초기 추정에 따라 변화 전 3DGS의 3D Gaussian 중 물체 3D mask 안에 있는 것들을 추정된 pose 변화만큼 이동시킨다. 변환된 Gaussian \(\mathcal{G}^{\mathcal{T}}\) 로 변화 후 view에서 이미지를 렌더링해 촬영 이미지와 비교하고, 변화 전 Gaussian 파라미터는 고정한 채 photometric 오차를 최소화해 pose 추정을 정제한다.
\[\mathcal{T}^*_{c'_n}, \mathcal{T}^*_k = \operatorname*{arg\,min}_{\mathcal{T}_{c'_n}, \mathcal{T}_k} \sum_{n=1}^{N} \mathcal{L}\left\{ \mathcal{R}(\mathcal{T}_{c'_n}; \mathcal{G}^{\mathcal{T}})\, \bar{\mathrm{M}}_n,\; I'_n\, \bar{\mathrm{M}}_n \right\}\]여기서 \(\bar{\mathrm{M}}_n\) 은 view \(n\) 의 move-out mask를 뒤집은 것으로, 재배치로 드러난(변화 전 3DGS가 관측하지 못한) 영역의 영향을 배제한다. \(\mathcal{L}\) 은 3DGS 학습 loss이고, 최적화는 표준 gradient descent로 푼다.
IV-H. Occlusion-aware mask projection
평가용 이미지가 주어지면 3D 물체 segmentation을 그 카메라 view에 occlusion을 고려해 투영한다. 먼저 IV-B와 IV-G대로 평가 view 카메라 pose를 추정·정제하고, 평가 이미지가 변화 후 이미지면 점유 voxel을 변환한 뒤 투영해 초기 mask를 얻는다. 초기 mask 안에서 depth를 렌더링하고(변화 전 이미지는 \(\mathcal{G}\), 변화 후 이미지는 \(\mathcal{G}^{\mathcal{T}}\) 사용) 3D로 역투영해, 역투영된 depth가 3D segmentation 안에 있는지로 픽셀별 occlusion을 검사한다. 가려진 픽셀은 0으로 리셋해 최종 mask를 얻는다.
IV-I. Implementation details
NeRFStudio의 3DGS 구현인 gsplat 위에 구축했다. SfM(IV-A)과 카메라 localization(IV-B)에는 HLoc을, feature 검출·매칭(IV-D)에는 SuperPoint+LightGlue를 쓴다. 모든 실험은 NVIDIA RTX 3090 GPU 한 장에서 수행했다.
V. Experiments
V-A. Datasets
radiance field 기반 change detection을 위한 공개 데이터셋은 물체·부품의 제거/삽입 같은 단순 변화에 집중한 NeRF-CD가 유일하다. 더 복잡한 시나리오 평가를 위해 어수선한 환경에서 물체 이동·교환(swap)·삽입 등 다양한 재배치가 일어나는 실세계 데이터셋 3DGS-CD를 수집했다. Mustard, Desk, Swap, Bench, Sill의 5개 scene으로, scene당 변화 전 이미지 약 150~200장과 변화 후 이미지 8장(삽입 물체 분할을 돕기 위해 60장인 Sill 제외)을 담는다. 변화 후 이미지의 절반은 change detection에, 절반은 평가에 쓴다. C-NeRF baseline과의 공정한 비교를 위해 NeRF-CD 데이터셋의 첫 테스트 scene Cats(물체 제거)에서도 평가하며, 변화 후 이미지 4장을 샘플링해 쓰고 평가는 데이터셋이 제공하는 원래 평가 이미지로 한다.
V-B. Metrics
2D change detection의 표준대로 평가 view의 2D change mask(move-in + move-out)를 ground truth와 비교해 Precision(%), Recall(%), F1(%), IoU(%)를 보고한다. runtime도 보고하는데, change detection과 mask 투영/예측 시간을 포함하고 NeRF·3DGS 학습 시간은 제외한다.
V-C. Baselines
- MTP: state-of-the-art 2D change detection 방법. 원격 탐사 데이터로 사전학습된 다중 태스크 foundation model을 2D change detection에 fine-tuning한 것으로, 자체 데이터에서 가장 좋았던 ViT-B+RVSA(CDD fine-tuned) 모델을 쓴다
- C-NeRF: state-of-the-art NeRF 기반 3D change detection. joint SfM으로 같은 좌표계에 변화 전후 NeRF 두 개를 학습하고 방향 일관 radiance 차이를 3D에서 식별한다
- C-NeRF-Diff: 변화 전후 NeRF 렌더링의 photometric 차이를 계산하는 C-NeRF 저자들의 baseline
- D-NeRF-Diff: 두 이미지 집합을 두 시간 스텝으로 D-NeRF를 학습하고 평가 view 렌더링의 절대 색 차이로 change mask를 계산
- 4DGS-Diff: 비슷하게 4DGS를 두 시간 스텝으로 학습해 시간별 렌더링의 색 차이로 change mask를 얻음
3DGS-CD 데이터셋에서는 MTP를 baseline으로 쓴다(C-NeRF는 sparse한 새 이미지로 변화 후 NeRF를 제대로 학습하지 못해 제외). NeRF-CD 데이터셋에서는 C-NeRF, C-NeRF-Diff, D-NeRF-Diff, 4DGS-Diff와 비교한다.
V-D. Results
3DGS-CD 데이터셋의 정량 결과가 Table 1, 정성 결과가 Figure 3·4다. 모든 테스트에서 모든 metric이 일관되게 90%를 넘는 높은 정확도를 보이며, 복잡한 scene의 3D 변화 감지에 약 18~58초가 걸린다. MTP baseline보다 큰 차이로 정확하다(MTP는 신경망 inference라 runtime은 더 빠르다). MTP는 도메인 내 데이터 fine-tuning으로 개선될 수 있겠지만, 이 방법은 fine-tuning 없이 강한 zero-shot 성능을 보인다.
| Data | Methods | Precision ↑ | Recall ↑ | F1 ↑ | IoU ↑ | Time |
|---|---|---|---|---|---|---|
| Mustard | Ours | 97.68 | 98.75 | 98.21 | 96.48 | 19s |
| MTP | 94.88 | 23.08 | 37.13 | 22.80 | 1s | |
| Desk | Ours | 99.17 | 95.82 | 97.47 | 95.06 | 21s |
| MTP | 95.69 | 34.38 | 50.58 | 33.85 | 1s | |
| Swap | Ours | 98.84 | 98.82 | 98.83 | 97.69 | 28s |
| MTP | 94.19 | 24.61 | 39.03 | 24.25 | 1s | |
| Bench | Ours | 96.51 | 96.76 | 96.64 | 93.49 | 58s |
| MTP | 90.19 | 88.74 | 89.46 | 80.93 | 1s | |
| Sill | Ours | 95.00 | 97.86 | 96.41 | 93.07 | 18s |
| MTP | 48.25 | 30.84 | 37.63 | 23.17 | 2s |
[Table 1] 3DGS-CD 데이터셋에서의 정량 평가(굵게 최고)
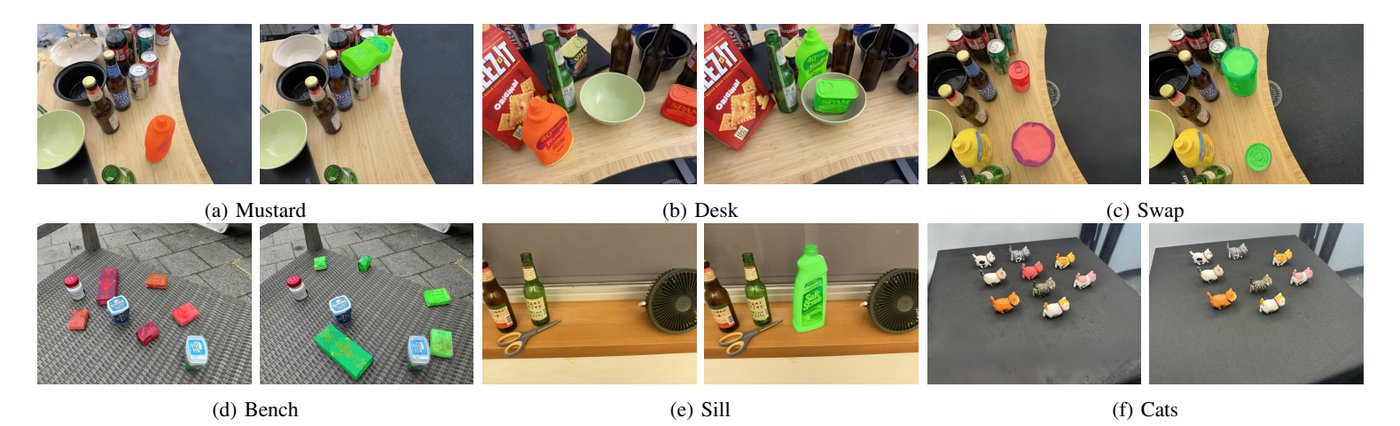 [Figure 3] 각 scene의 같은 novel 시점에서 변화 전 3DGS 렌더링(왼쪽)에 move-out mask(빨강), 변화 후 촬영(오른쪽)에 move-in mask(초록)를 투영한 정성 결과
NeRF-CD 데이터셋의 Cats scene 결과가 Table 2다. C-NeRF보다 최대 14% 더 정확하고 556배 빠르다. 이 속도 차이는 C-NeRF가 변화 식별과 mask 렌더링에 비싼 ray tracing을 쓰는 반면, 이 방법은 EfficientSAM, 실시간 3DGS 렌더링, 빠른 고전 컴퓨터 비전 기법으로 pipeline을 구성했기 때문이다. dynamic NeRF/3DGS 기반 baseline들(D-NeRF-Diff, 4DGS-Diff)도 큰 차이로 앞서는데, 이 모델들은 정확한 3D 변화 예측을 위해 설계·최적화된 것이 아니므로 예상된 결과다.
| Methods | Precision ↑ | Recall ↑ | F1 ↑ | IoU ↑ | Time |
|---|---|---|---|---|---|
| 3DGS-CD | 97.94 | 95.62 | 96.76 | 93.73 | 22s |
| C-NeRF | 86.70 | 90.46 | 88.54 | 79.47 | 3.4h |
| C-NeRF-Diff | 58.80 | 83.50 | 68.86 | 52.70 | - |
| D-NeRF-Diff | 59.24 | 60.57 | 59.68 | 42.71 | - |
| 4DGS-Diff | 62.44 | 90.73 | 73.97 | 58.69 | - |
[Table 2] NeRF-CD 데이터셋 Cats scene에서의 정량 평가(굵게 최고). *-Diff baseline들은 명시적 change detection 단계가 없어 runtime 생략
V-E. Ablation study
변화 후 이미지 수. Cats scene에서 change detection에 쓰는 변화 후 이미지 수를 바꿔가며 같은 평가 이미지로 평가했다. Figure 5처럼 이미지 수가 달라져도, 단 1장만 써도 안정적인 성능을 유지한다. 이미지가 적을 때의 약간의 정확도 하락은 제한된 view로 만든 불완전한 물체 template이 변화 전 이미지에 대한 EfficientSAM box prompt 품질을 떨어뜨리기 때문이다.
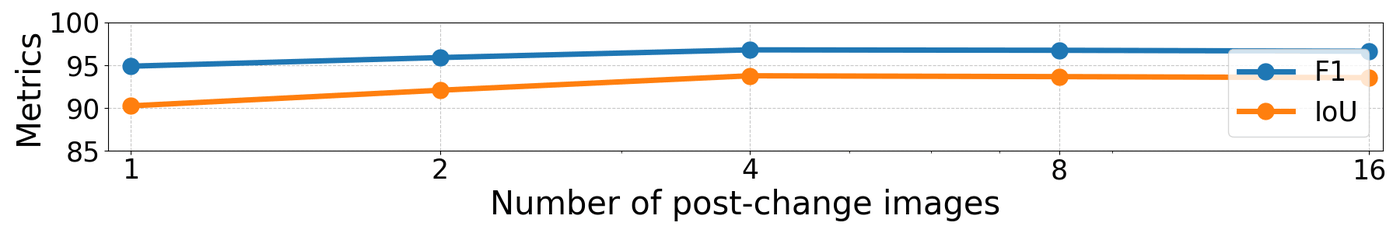 [Figure 5] Cats scene에서 변화 후 이미지 수에 따른 성능 변화
VI. Applications
이 방법은 radiance field 기반 3D change detection의 정확도와 효율을 크게 끌어올려 다양한 실세계 응용을 가능하게 한다. 세 가지 활용 예시를 보인다.
VI-A. Object removal as prompt for object reconstruction
NeRF·3DGS 덕에 폰으로 찍은 RGB 이미지만으로 물체 3D reconstruction이 쉬워졌지만, 어수선한 환경의 복잡한 물체는 입력 이미지들에서 같은 전경 물체를 일관되게 분리하기 위한 사용자 prompt가 필요하다. 클릭 prompt는 클릭 하나가 부품인지 물체 전체인지 모호한 다중 granularity 문제를 겪고, 언어 prompt도 비슷한 물체가 여럿이면 혼동을 일으킨다. state-of-the-art prompt 기반 3DGS 분할 방법인 SAGA조차 단일 클릭으로는 물체 전체를 분리하지 못했고, 정확한 클릭 여러 개가 필요했으며, GPT-4o가 생성한 언어 prompt(“Coke cup with a wolverine figurine on the lid”)로도 실패했다.
이에 물체 제거 자체를 모호하지 않은 prompt로 쓰는 것을 제안한다. scene 속 물체를 찍은 뒤 물체를 치우고 몇 장 더 찍으면, 이 방법이 변화 전 이미지들에서 대상 물체를 일관되게 식별해 모호성 없이 object-3DGS를 학습할 수 있다. 클릭·언어 prompt보다 직관적이고 사용자 노력이 적다.
VI-B. Robot workspace reset
이동한 물체의 형태와 pose 변화를 정밀하게 추정하므로, 로봇 manipulator가 scene을 초기 상태로 리셋할 수 있다. 창고나 가사 로봇처럼 작업 후 작업 공간 리셋이 중요한 응용에 유용하다. 과정은 (1) RGB 비디오로 초기 상태 스캔, (2) 물체 이동, (3) 변화 후 RGB 몇 장 촬영, (4) 이 방법으로 30초 안에 이동 물체의 형태·pose 변화 추정, (5) 로봇 pick-and-place로 리셋이다. 기존 해법(SayCan 등) 대비 depth 센서·물체 클래스·detector·모호할 수 있는 언어 prompt가 모두 불필요하고, 물체 위치·방향을 정밀하게 리셋한다. PyBullet 시뮬레이션에서 로봇 팔이 테이블 위 머그컵 pose를 리셋하는 실험을 보였는데, 이때는 SfM 대신 forward kinematics로 카메라 pose를 얻고 Gaussian을 무작위 초기화했다.
VI-C. Fast sparse-view-guided 3DGS update
초기 정적 scene의 3DGS를 학습한 뒤 scene이 바뀌면, sparse한 변화 후 이미지의 유도만으로 초기 3DGS를 물리적 변화에 맞게 업데이트할 수 있다. 3DGS의 명시적 성질 덕에 변한 물체의 Gaussian은 그대로 변환하면 되고, 어려운 것은 재배치로 새로 드러난 미관측 영역의 복원이다. in-painting 기반 해법 대신 변화 후 이미지의 supervision을 직접 활용한다. 물체 내부의 사전 최적화된 Gaussian을 추정된 움직임대로 변환하고 사전학습 파라미터는 모두 고정한 뒤, 새로 드러난 영역 근처의 Gaussian을 복제해 그 복제본만 최적화해 빈 곳을 채운다. 복제본은 위치·색이 비슷해 sparse-view supervision 아래 좋은 초기화가 된다. 1000 스텝 최적화하며 100 스텝마다 adaptive control로 Gaussian을 분할·복제·리셋·제거한다.
NeRF-Update 데이터셋의 Soda scene(변화 전 174장으로 3DGS 학습, 변화 후 4장으로 업데이트)에서 move-in/move-out 영역의 PSNR·SSIM과 runtime을 평가했다(Table 3). NeRF-update와 대등한 복원 품질을 더 빠른 시간에 달성하고, 변화 후 4장만으로 학습한 InstantSplat은 더 빠르지만 품질이 낮다.
| Methods | Move-in PSNR | Move-in SSIM | Move-out PSNR | Move-out SSIM | time (s) |
|---|---|---|---|---|---|
| 3DGS-update (Ours) | 17.01 | 0.46 | 15.51 | 0.31 | 49 |
| NeRF-update | 17.39 | 0.50 | 14.61 | 0.30 | 168 |
| InstantSplat | 15.35 | 0.36 | 13.47 | 0.14 | 31 |
[Table 3] NeRF-update 데이터셋 Soda scene에서의 3DGS/NeRF 업데이트 방법 평가(move-in/move-out 영역 평균 PSNR·SSIM ↑ 과 업데이트/학습 시간. 굵게 최고)
VII. Limitations
비강체 변화: 물체 pose 변화를 6DoF rigid 변환으로 표현하므로 비강체 변화에 바로 적용하기 어렵다. 다만 pipeline이 모듈식이라 pose 추정 모듈 외에는 강체 가정에 의존하지 않아, 비강체 pose 추정 방법을 쉽게 통합할 수 있다.
심한 occlusion: 변화가 모든 변화 후 view에서 심하게 가려지면 물체 template이 불완전해져 3D 분할이 실패할 수 있다. 가능하면 occlusion을 최소화하는 각도에서 변화 후 이미지를 찍기를 권장한다.
전경-배경 semantic 유사성: 2D change detection 모듈의 성공은 이동한 물체와 배경의 semantic 구별에 달려 있다. 사과 더미에서 사과 하나를 빼는 것처럼 물체와 배경이 semantic하게 유사하면 성능이 떨어질 수 있다. EfficientSAM 기반 접근을 photometric 차분과 결합해 semantic·시각 차이를 함께 평가하면 완화할 수 있다.
VIII. Conclusions
복잡한 실세계 환경에서 3D 물체 수준 변화를 식별하는 새로운 3DGS 기반 change detection 방법을 개발했다. radiance field 기반 3D change detection의 정확도와 효율을 크게 개선해 광범위한 실세계 응용을 가능하게 한다.